


Formation Copilot : ce que 3 heures de pratique changent pour vos équipes



Vos équipes ont Copilot. L'utilisent-elles ? À 30 USD par utilisateur et par mois (prix public Microsoft, octobre 2026), la question se pose dans chaque direction qui a signé le déploiement. Entre la licence activée et l'usage quotidien, l'écart tient le plus souvent à la méthode.
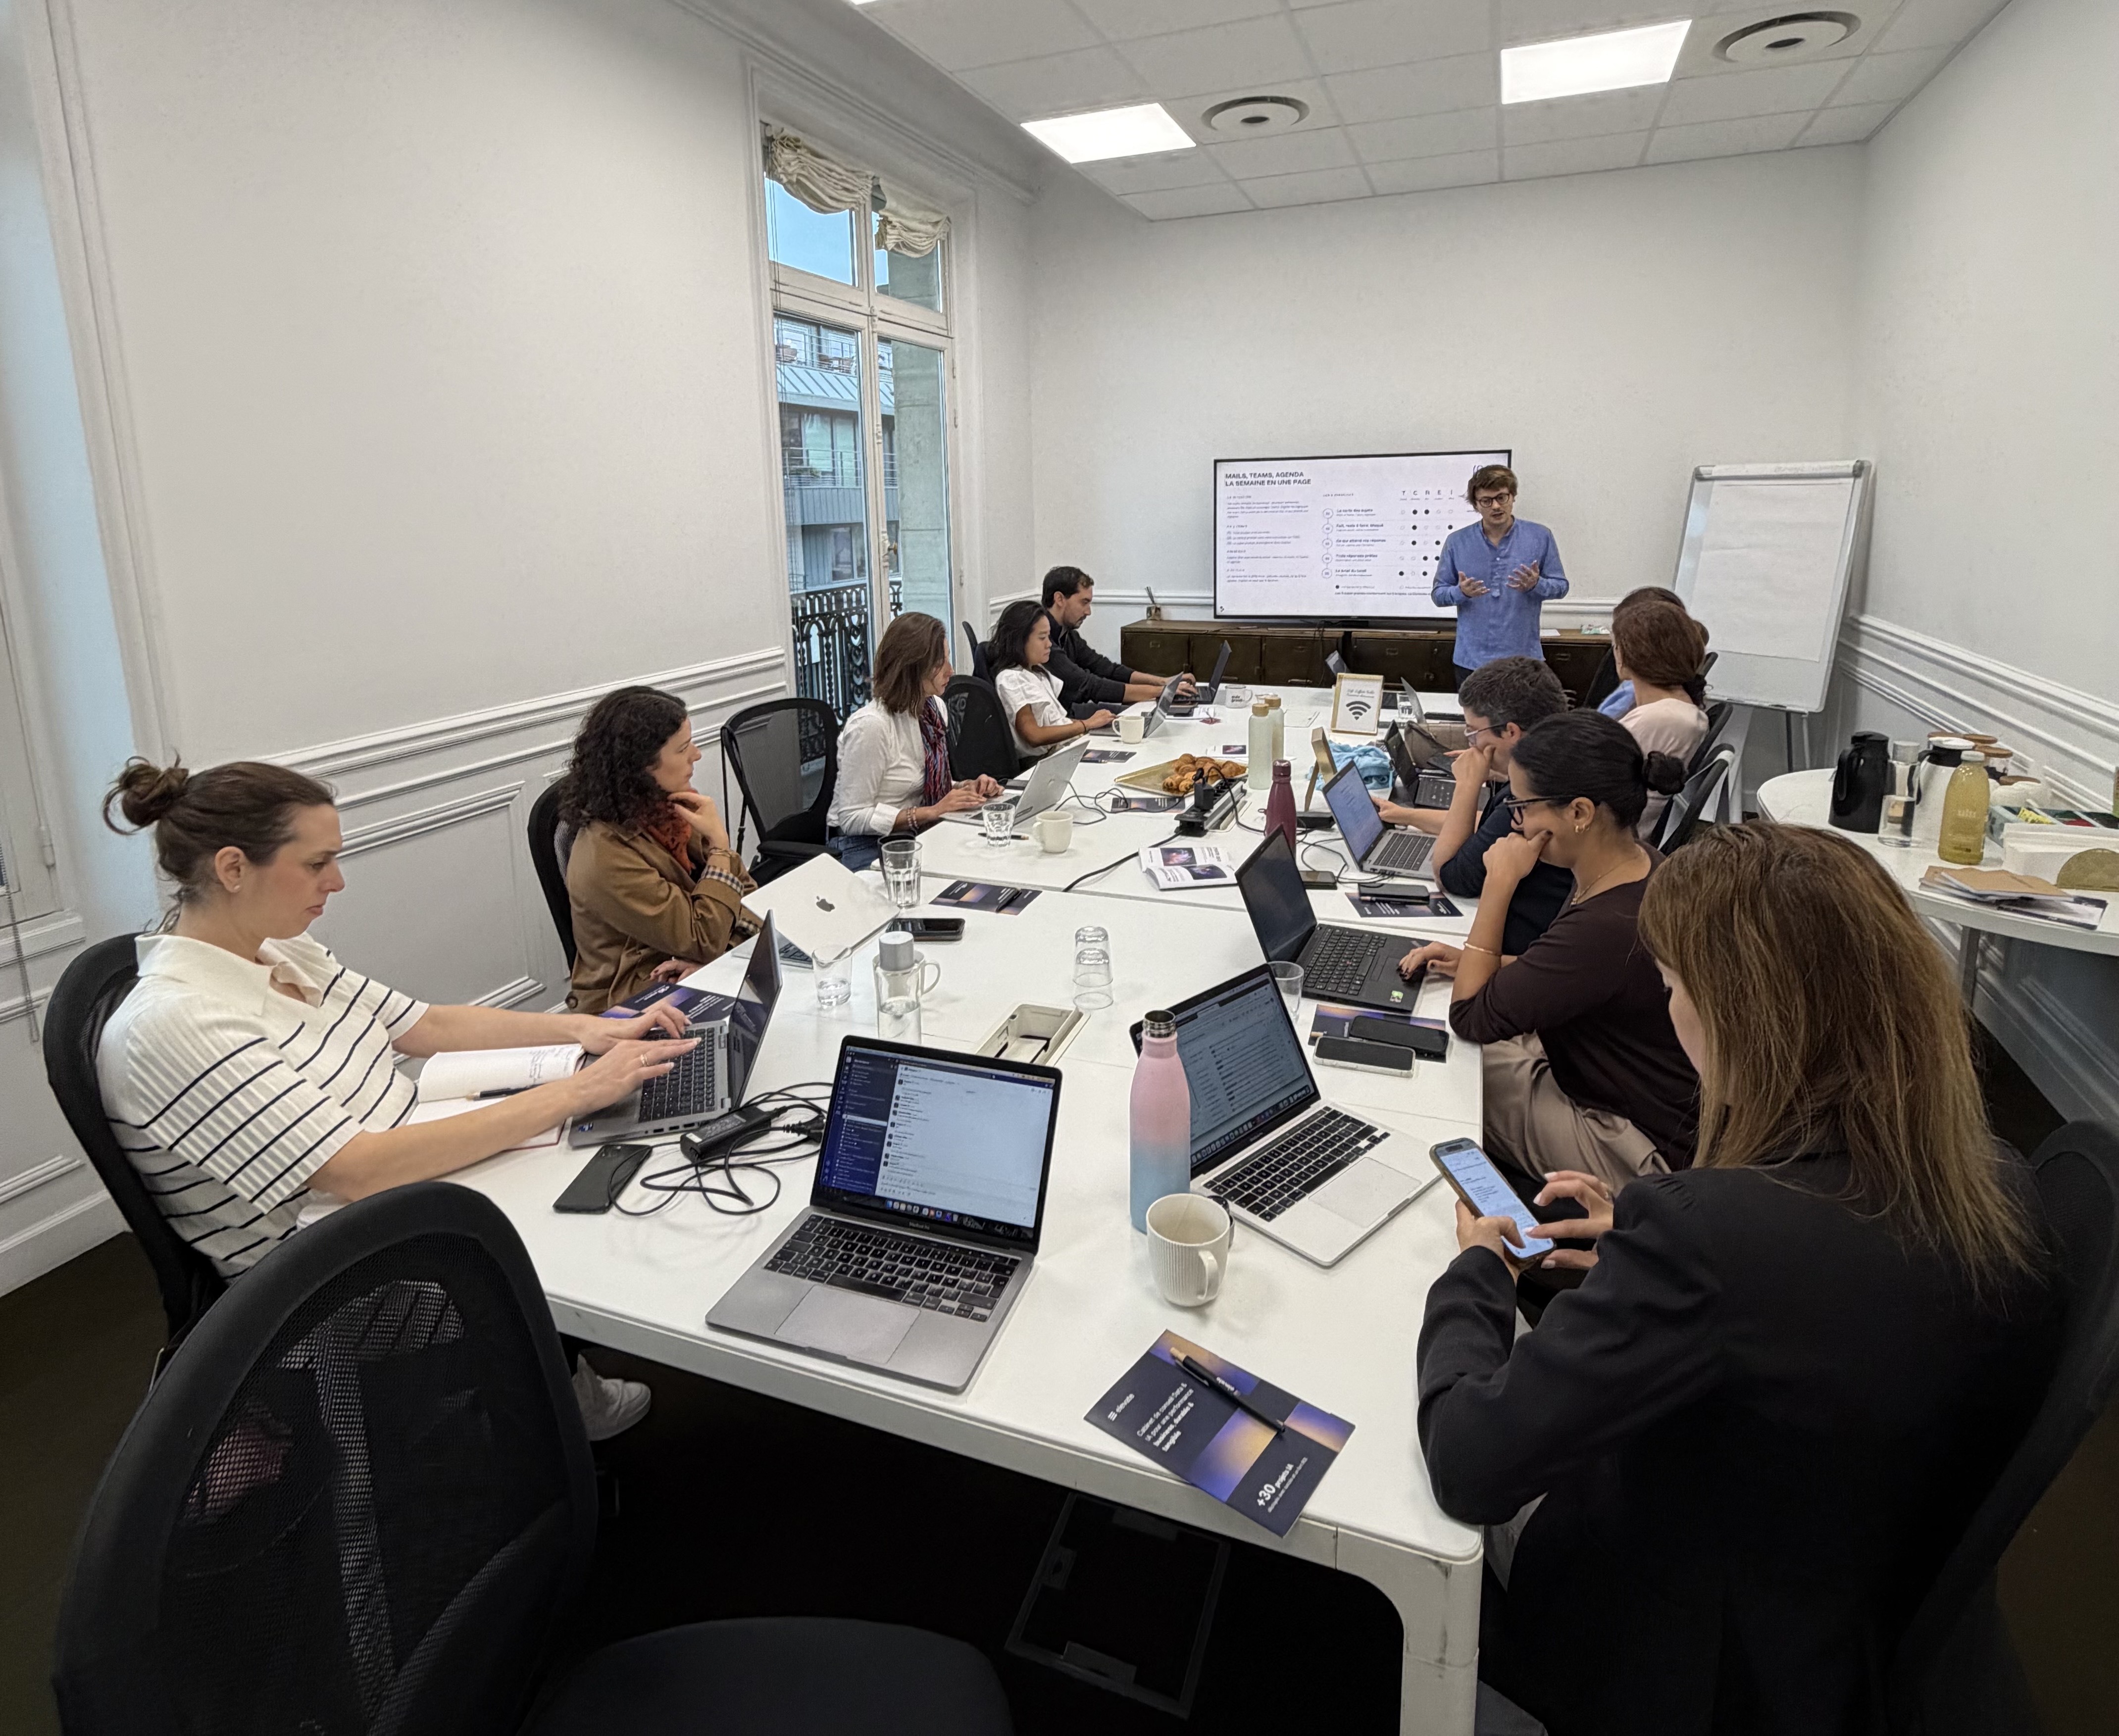
C'est le pari de The Path : Copilot, la table ronde que nous avons organisée en octobre. Trois heures, trois ateliers joués en live sur un vrai Copilot, et des participants qui repartent avec des prompts testés sur leurs propres dossiers. Retour sur ce que la séance a montré, et sur ce qu'elle change pour une organisation qui veut passer de l'essai au réflexe.
1. Licence activée, usage absent : le constat de départ
Jusqu'à présent, le déploiement de Copilot s'est souvent résumé à l'attribution de licences. Le tour de table d'ouverture l'a confirmé : chaque participant a situé son usage de 0 (« jamais ouvert ») à 4 (« j'ai créé un agent »), et les mêmes freins sont revenus d'une entreprise à l'autre.
Le premier tient à la façon d'interroger l'outil. Une question posée comme dans un moteur de recherche, sans contexte ni livrable attendu, donne une réponse générique, et l'utilisateur conclut que Copilot n'apporte pas grand-chose. Le deuxième tient à la confiance : on hésite à lui confier ses mails ou ses fichiers, ou à l'inverse on reprend ses réponses sans vérifier les chiffres. Le troisième tient au temps : sans cas d'usage identifié dans son propre quotidien, Copilot reste un outil qu'on ouvre quand on y pense.
Ces freins relèvent de la pratique plus que de la technologie. Ils se lèvent sur des cas réels, avec une méthode commune à toute l'équipe.
2. TCREI : une méthode commune pour écrire un prompt
Tous les prompts de l'atelier ont été construits avec la même méthode, TCREI. Ses cinq étapes couvrent à la fois la rédaction du prompt et le travail sur la réponse :
- Task (tâche) : ce que Copilot doit produire, le rôle qu'il doit jouer et le format attendu (« Tu es mon chef de cabinet. Un tableau, un sujet par ligne »).
- Context (contexte) : la situation, le périmètre, le public visé et les contraintes.
- References (références) : les sources à utiliser ou les exemples à suivre, qu'il s'agisse de fichiers, de mails ou d'un modèle de livrable.
- Evaluate (évaluer) : relire la réponse et vérifier chiffres, calculs et sources avant de l'utiliser.
- Iterate (itérer) : ajuster le prompt dans la même conversation jusqu'au résultat attendu.
Les trois premières étapes font la qualité du prompt, les deux dernières celle du livrable. C'est sur ces deux dernières que la séance a le plus insisté, car une réponse plausible n'est pas une réponse juste.
3. Trois ateliers, trois cas d'usage métier
Chaque atelier a été joué en direct, sur un vrai Copilot, en partant d'un prompt simple pour arriver à un prompt structuré selon TCREI. Quand une réponse était fausse, elle a été montrée aussi : c'est une information utile pour l'utilisateur.
Atelier 1 : mails, Teams et agenda, la semaine en une page
Les sujets arrivent en morceaux : plusieurs interlocuteurs, plusieurs fils, des mails et des messages Teams. Faire le point de la semaine prend du temps, et les demandes urgentes se perdent dans le volume.
L'atelier enchaîne cinq prompts dans une même conversation, sur une vraie boîte de réception. Le premier pose la tâche complète : Copilot joue le rôle d'un chef de cabinet, travaille sur les 7 derniers jours, ignore les newsletters et rend un tableau avec un sujet par ligne. Les suivants ne réécrivent que ce qui change :
- La carte des sujets, regroupés par projet même quand ils arrivent par des personnes différentes, avec décisions, chiffres et échéances.
- Le point de la semaine en trois rubriques (fait, reste à faire, bloqué), une fois l'agenda ajouté au contexte.
- Les messages qui attendent une réponse, triés par urgence, avec un signalement des urgences qui ne se présentent pas comme telles.
- Trois réponses rédigées de quatre lignes chacune, avec une action datée, à relire avant envoi.
- Un brief de la semaine enregistré dans la bibliothèque de prompts et programmé chaque lundi à 10h.
Le résultat : la semaine se lit en une page, sans relire un seul fil, et le brief du lundi arrive sans action de l'utilisateur.
Atelier 2 : analyse de données, vérifier avant de présenter
Le scénario : un distributeur fictif, trois fichiers bruts (ventes de janvier à août, objectifs, calendrier des actions commerciales) et un comité commercial dans une heure. Le fichier de ventes contient 485 lignes et 10 types d'erreurs semées : doublons, libellés hétérogènes, valeurs multipliées par 10, taux supérieurs à 100 %, ligne manquante.
Premier temps, un prompt naïf : « Analyse ces fichiers et dis-moi ce que je dois présenter au comité ». La réponse est plausible, bien rédigée, et calculée sur des données non contrôlées. Question posée à la salle : vous présenteriez ces chiffres ?
Second temps, dans une nouvelle conversation avec l'agent Analyst, le prompt confie à Copilot le rôle d'un contrôleur de gestion senior, garant de la fiabilité des chiffres en comité. Il impose cinq étapes dans l'ordre : contrôle qualité, corrections, lecture d'ensemble, comparaison aux objectifs, puis hypothèses testées en croisant les trois fichiers. Trois règles l'encadrent : aucune hypothèse non étayée, un calcul montré pour chaque chiffre clé, une distinction nette entre le constaté et le supposé. Trois signaux sortent des données corrigées :
- Des retours en ligne passés de 8,2 % à 19,3 % dans une région, soit 2,4 fois plus. La saisonnalité et la météo sont écartées par comparaison avec une région voisine ; le changement de transporteur début juin explique l'écart.
- Une gamme à 114 % de son objectif de chiffre d'affaires, mais dont la marge e-commerce passe de 49 % à 38 % depuis le lancement d'un code promo : une croissance achetée.
- Un NPS qui recule de 19 points et des réclamations qui passent de 30 à 86 après la migration d'un outil de service client, alors que le chiffre d'affaires ne montre encore rien.
Le résultat : une analyse présentable en comité, où chaque chiffre est vérifié et chaque explication écartée l'est sur la base des données.
Atelier 3 : veille concurrentielle, chaque lundi ce qui change une décision
L'information sur les concurrents existe déjà, mais elle arrive trop tard ou noyée dans le bruit. L'atelier construit à l'écran une veille sur 3 à 5 concurrents choisis par la salle. Il part d'un prompt simple, une ligne par information avec date et lien, et vérifie deux liens en direct. Il passe ensuite à un prompt complet en quatre étapes :
- Collecter les signaux des 7 derniers jours sur les offres, prix, partenariats, nominations et résultats, avec date et lien.
- Filtrer pour ne garder que ce qui peut changer une décision dans les 3 mois, en comptant ce qui est écarté.
- Qualifier chaque signal : ce qui change pour l'entreprise, la décision touchée, une alerte rouge, orange ou verte.
- Conclure sur le signal le plus structurant de la semaine et l'action à lancer.
Le prompt fixe ses propres garde-fous : aucune information sans lien daté, aucune source de plus de 7 jours, l'annoncé distingué de l'effectif, et une auto-vérification des liens en fin de réponse. Le piège montré en live est un lien qui n'existe pas ou qui date de plus d'une semaine : on le repère, puis on demande à Copilot de vérifier ses sources.
Le résultat : une note de veille prête pour le comité de direction, programmée chaque lundi à 8h. Reste un choix à faire avec les équipes : limiter Copilot au web, ou l'autoriser à croiser aussi ce qu'elles ont déjà écrit sur ces concurrents dans leurs mails et documents.
4. Les 6 réflexes à retenir
La conclusion de la séance tient en six réflexes, chacun rattaché à un atelier :
- Poser la tâche complète : le rôle, le livrable et le format attendu.
- Donner le contexte et les références plutôt que laisser Copilot deviner.
- Enchaîner dans la même conversation plutôt que tout réécrire.
- Contrôler les données avant de conclure.
- Exiger le calcul et la source, et faire tester l'explication concurrente.
- Programmer ce qui revient chaque semaine.
5. Déployer Copilot à l'échelle d'une direction
Une séance montre ce que Copilot sait faire. L'adoption durable demande un déroulé en trois phases, que nous construisons avec chaque client :
- Phase 1, le socle : licences, agents et prompts planifiés activés, et un audit des documents surpartagés que Copilot rendrait trouvables.
- Phase 2, les cas métier : des ateliers par équipe sur leurs propres cas, sur le modèle de The Path.
- Phase 3, la capitalisation : une bibliothèque de prompts métier partagée et une mesure de l'adoption dans le temps.
Ce format s'appuie sur l'expérience du groupe HumanSkills : plus de 3 000 personnes formées à l'IA avec plus de 99 % de satisfaction, plus de 60 cas d'usage IA déployés chez nos clients, et plus de 350 décideurs réunis lors de notre séminaire IA d'avril 2026.
De la licence au réflexe
Copilot ne crée pas l'usage à lui seul. Ce qui fait la différence, c'est une méthode partagée pour écrire les prompts, des cas pris dans le quotidien des équipes et l'habitude de vérifier avant de présenter. Trois heures suffisent pour amorcer ce changement, à condition de partir des vrais dossiers de vos équipes.
Vous souhaitez organiser un The Path sur les cas de vos équipes, ou faire le point sur l'adoption de Copilot dans votre organisation ? Prenons rendez-vous pour en parler.
Plus d’actualités
Formation Copilot : ce que 3 heures de pratique changent pour vos équipes
Du catalogue technique à la valeur métier : comment structurer une gouvernance data performante
Data Engineering : comment bâtir une infrastructure résiliente face à l'explosion des volumes


